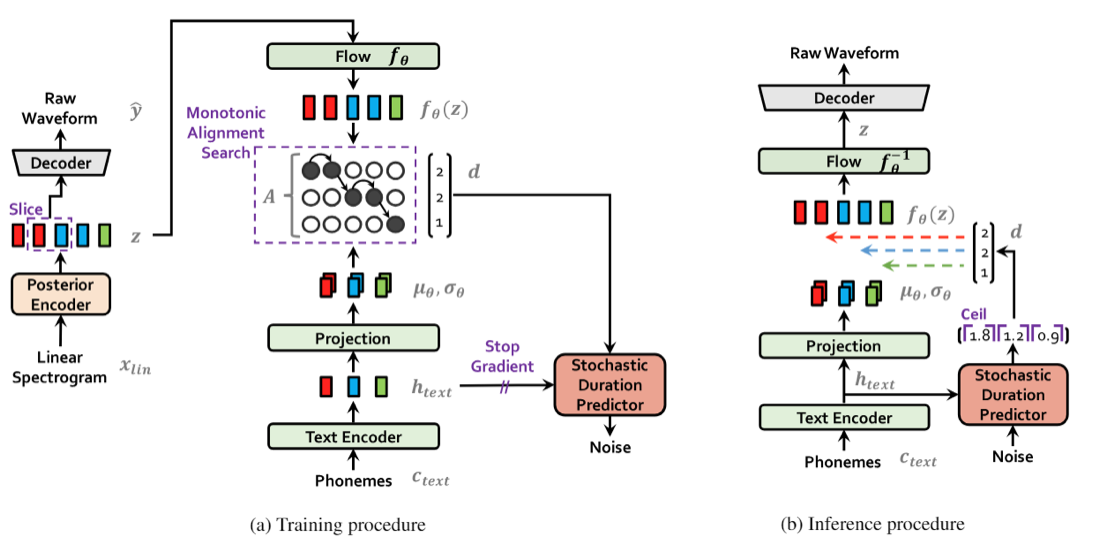
VITS: Conditional Variational Autoencoder with Adversarial Learning for End-to-End Text-to-Speech
변분 추론과 적대적 학습을 결합한 end-to-end 음성 합성 모델 VITS를 살펴봅니다. 조건부 VAE와 정규화 흐름 기반 구조를 정리합니다.
계속 읽기변분 추론과 적대적 학습을 결합한 end-to-end 음성 합성 모델 VITS를 살펴봅니다. 조건부 VAE와 정규화 흐름 기반 구조를 정리합니다.
계속 읽기