VITS: Conditional Variational Autoencoder with Adversarial Learning for End-to-End Text-to-Speech
이 글의 목차
- Conditional Variational Autoencoder with Adversarial Learning for End-to-End Text-to-Speech
- 2. Method
- 2.1 Variational Inference
- 2.1.2 Reconstruction Loss
- 2.1.3 KL-DIVERGENCE
- 2.2 Alignment Estimation
- 2.2.1. Monotonic alignment search
- 2.2.2. Duration Prediction From Text
- 2.3. Adversarial Training
- 2.4. Final Loss
- 2.5. Model Architecture
- 2.5.1. Posterior Encoder
- 2.5.2. Prior Encoder
- 2.5.3. Decoder
- 2.5.4. Discriminator
- 2.5.5. Stochastic Duration Predictor
- 3. Experiments
- 4. Result
Variational Inference with adversarial learning for end-to-end Text-to-Speech (VITS).
Conditional Variational Autoencoder with Adversarial Learning for End-to-End Text-to-Speech
Abstract
최근 TTS모델은 single-stage 학습과 병렬 sampling이 목적이었다. 그러나
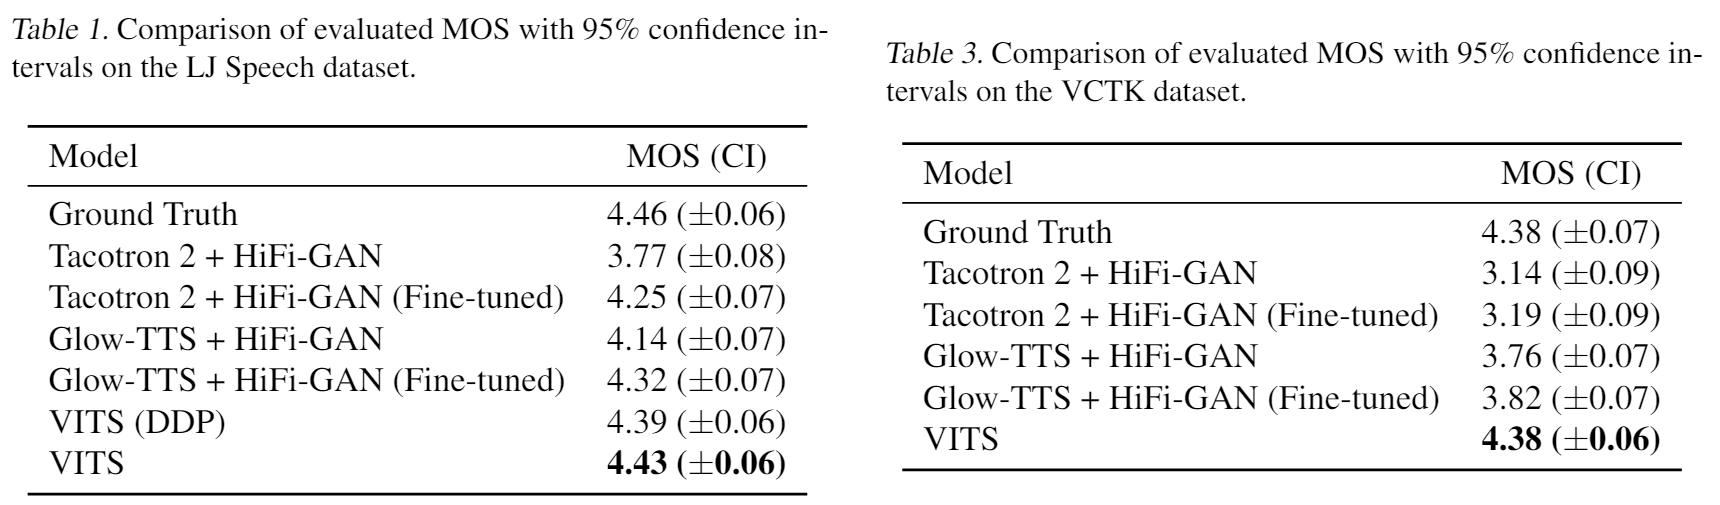
sample 질은 2개 stage TTS 와 맞지 않다. 이 작업에서 two-stage 모델보다 우리는 자연스럽게 들리는 오디오를 병렬과 end-to-end TTS 모델을 준비했다. 우리의 방법은 노말라이징 flow와 adversarial 학습을 통해 증강된 적응된 variational inference이다. 또한 stochastic duration predictor를 사용해서 입력 문장과 다양한 리듬에 합성하는 것을 제안한다. 1대다 관계에서 다른 pitches와 리듬에 여러 방법으로 말할 수 있는 텍스트를 표현한다. LJ speech 에서 한 발화자 데이터셋에서 우리의 방법이 MOS 메트릭으로 측정했을 때 가장 좋다.
Introduction
TTS는 text normalization과 phonemization와 별도로 two-stage generation modeling 으로 단순화됐다. 첫번째는 mel-spectrogram이나 linguistic feature 같은 중간 speech representations이고 두 번째 단계는 중간 representations에서 raw waveforms 을 생성하는 것이다. 모델은 독립적으로 개발되었다.
기존에 병렬 processor 활용 제한을 극복하고 합성 속도를 향상시키기 위해, 몇몇 non-autoregressive 방법론들이 제안됬다. text-to-spectrogram 생성 단계에서 학습된 autoregressive teacher network에서 attention map을 추출은 텍스트와 스펙트로그램의 align의 어려움을 감소시켰다. 더 최근에는 likelihood-based 방법론들이 대상 mel-spectrogram의 likelihood를 최대화하면서 외부 aligner에서 종속을 제거했다.
FasteSpeech 2s나 EATS는 전체 waveforms보단 짧은 audio clips 학습을 제안했고 length mismatch를 줄여서 특별한 스펙트로그램 loss를 설계했다. 그러나 two-stage systems 보단 합성 퀼리티가 느리다? 별로다.
본 논문에선 병렬 E2E TTS방법으로 현재 two-stage 모델보다 자연스러운 소리를 생성한다. Variational autoencoder(VAE) 시스템을 사용하고 latent를 효과적으로 E2E 학습하는 2가지 모듈을 연결했다. normalizaing flows를 상태 사전확률 분포에 적용했고, 적대적 학습을 waveform domain에 적용했다. one-to-many 문제에선 입력 텍스트의 다양한 문장과 음성에 합성하기위해 stochastic duration predictor를 제안한다.
2. Method
2.1 Variational Inference
conditional VAE에서 variational lower bound (ELBO)는 marginal log-likelihood 의 ELBO를 계산한다.
가 latent variable 에 대한 ( conditional) prior distribution 일때 는 데이터 에 대한 likelihood function 이다.
는 approximate posterior distribution.
training loss는 negative ELBO인 와 KL divergence 의 reconstruction loss 합과 KL divergence
2.1.2 Reconstruction Loss
reconstruction loss의 목적 데이터로는 raw wav보다 mel-spec을 사용한다(). latent variable 를 디코더를 통해 웨이브폼 으로 업샘플링하고, 이걸 로 변환한다. 그리고 이 값의 로스를 reconstruction loss로 사용한다. 이 msel-scale을 사용하는 loss로 perceptual 퀄리티를 높인다.
2.1.3 KL-DIVERGENCE
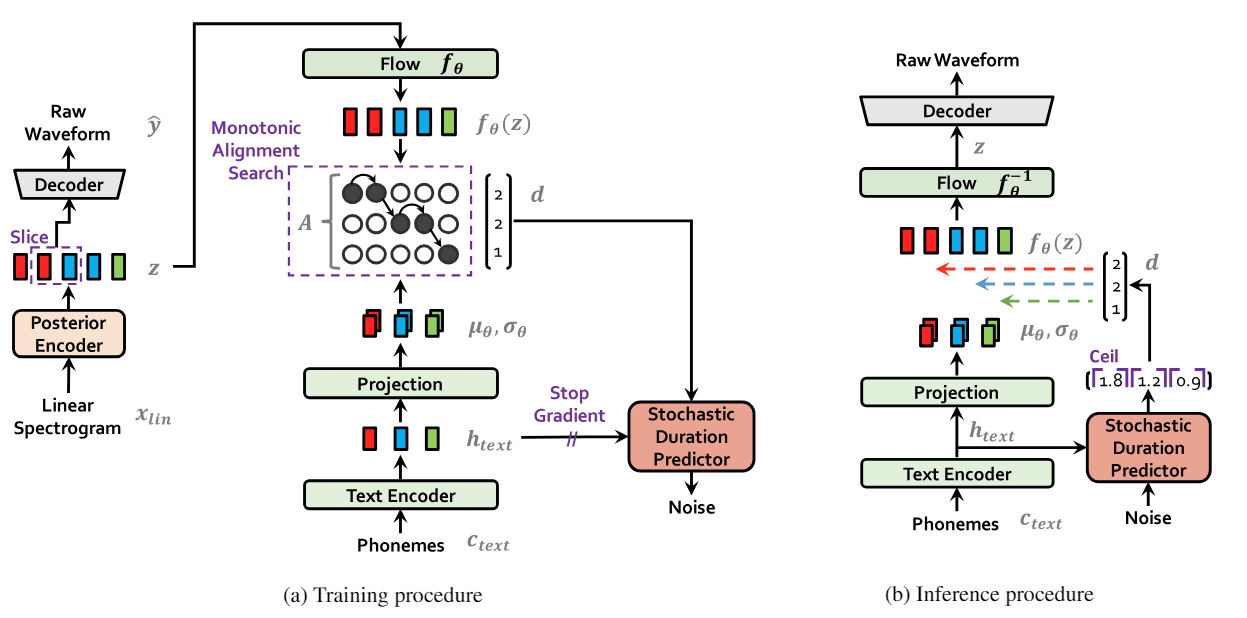
prior encoder c는 텍스트에서 추출한 phonemes 와 phonemes와 latent variables의 alignment A로 구성된다. alignment는 hard monotonic attention matrix 로 각 phoneme이 speech에 어떻게 매칭이 되는지를 나타낸다. posterior encoder에게 더욱 높은 resolution을 갖는 정보를 제공하기 위해 타겟 스피치 의 mel-spec 보다 linear-scale 스펙트로그램을 사용했다.
factorized normal distribution에 normalizing flow 라는 prior encoder와 posterior encoder을 사용했다. 변환을 가해 더 복잡한 모양의 distribution으로 만들어서 사용한다면 prior distribution expressiveness가 증가된다.
2.2 Alignment Estimation
2.2.1. Monotonic alignment search
텍스트와 음성 align을 위해 Monotonic alignment Search(MAS)를 사용한다. VAE의 목적함수인 ELBO에서는 정확한 log-likelihood가 없어서 원 논문에서 사용하는 dynamic programming을 바로 이용하기는 어렵다. 그래서 ELBO를 최대화 하는 것으로 재정의했다.
ASIS:
TOBE:
2.2.2. Duration Prediction From Text
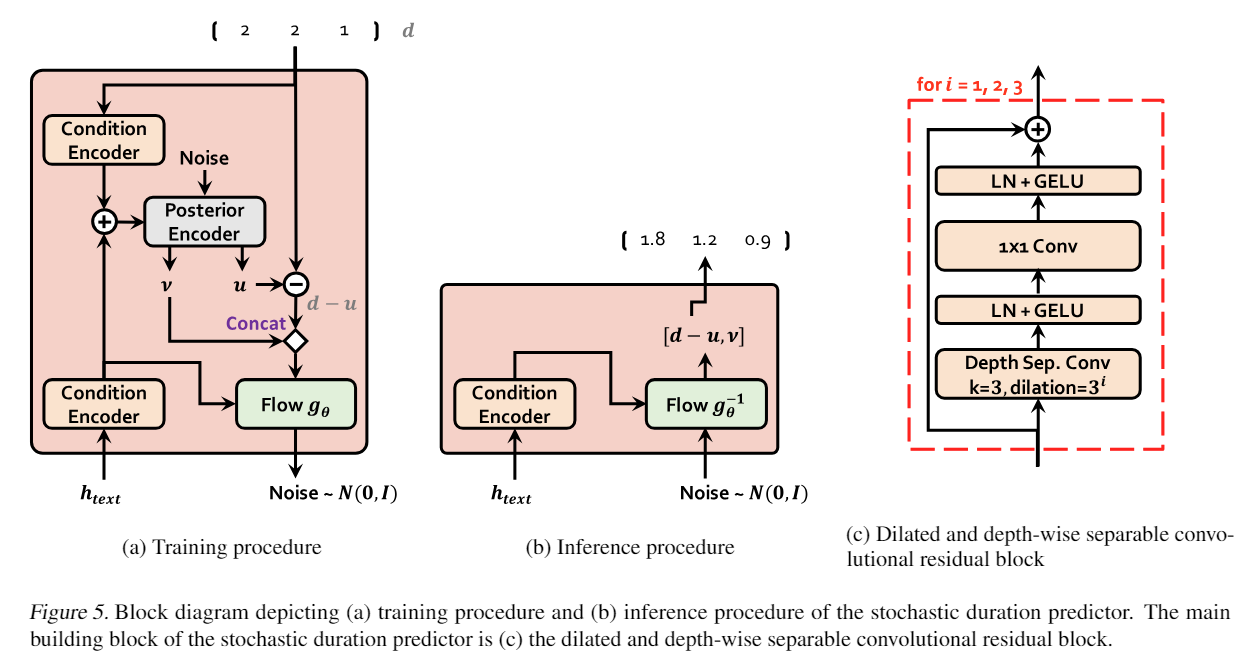
alignment 로 입력 토큰 의 길이를 구할수 있다. 그러나 사람같은 리듬으로 생성하기 위해서 flow-based generative model로 MLE 기반하여 학습하는 stochastic duction predictor를 사용한다. 그러나 입력 phoneme들의 길이가 정수이고 스칼라 값이기 때문임. 사실 이를 해결하기 위한 방법 variational dequantization와 variational data augmentation이 있다.
구체적으로 랜덤 변수 와 가 있다. 이는 duration sequence d와 같은 차원을 갖는 동시간 resolution과 dimension이다. 의 범위는 로 한정을 하여 가 항상 양의 실수가 되게 하고, 더 높은 차원의 latent representation을 위해 를 와 concat한다. 이 두 변수는 posterior distribution 에서 나온다.
phoneme duration의 log-likelihood의 ELBO 목적함수
이때 다른 모듈에 영향끼치지 않도록 stop gradient operator를 적용했다.
2.3. Adversarial Training
discriminator D, decoder G로 적대적 학습을 넣었다. 는 discriminator 레이어 수이고, 은 L 번째 레이어의 feature map 출력값이다. 개의 features로 discriminator가 구성된다.
feature-matching loss도 구성되어 있다.
2.4. Final Loss
VAE와 GAN학습으로 섞여있다.
2.5. Model Architecture
모델은 a posterior encoder, prior encoder, decoder, discriminator, and stochastic duration predictor으로 구성된다.
2.5.1. Posterior Encoder
WaveGlow와 Glow-TTS에서 사용한 non-causal WaveNet residual block을 사용한다. 이 block위에 linear projection layer를 추가해 normal posterior distribution의 파라미터를 생성한다.
multi-speaker의 경우에는 residual block안에 speaker embedding을 더해서 global conditioning을 이용한다.
2.5.2. Prior Encoder
text encoder를 통한 입력 phonemes 와 사전 분포의 유연성을 증가시키기 위한 normalizing flow 로 구성된다. 이 때 에 대한 를 얻고, 여기에 linear projection layer를 더해 prior distribution의 파라미터를 생성한다. normalizing flow은 WaveNet residual block을 쌓아서 구성된 affine coupling layer를 이다.
multi-speaker setting에서도 residual block에다가 speaker embedding을 더해서 사용함.
2.5.3. Decoder
decoder는 HiFi-GAN V1. transposed convolution과 multi-receptive field fusion (MRF) 모듈로 구성된다.
multi-speaker의 경우에 speaker embedding을 변형한 linear layer와 input latent variable 를 더한다.
2.5.4. Discriminator
discriminator는 HiFi-GAN에서 제안된 multi-period discriminator를 사용한다. 입력 waveforms의 다른 주기적 패턴에 따라 작용하는 Markovian window-based sub-discriminators이다
2.5.5. Stochastic Duration Predictor
conditional input 에서 나온 phoneme 길이의 분포를 추정한다. 효과적인 parameterization을 위해 dilated and depth-seperable conv레이어를 쌓아 구성한다. 또한 neural spline flows를 적용했는데, 이는 비슷한 숫자의 파라미터로도 더 좋은 transformation expressiveness를 나타낼 수 있다. multi-speaker의 경우 speaker embedding을 변형하여 input 에다가 더한다.
3. Experiments
Dataset: LJ Sppech dataset(single speaker 13100 short audio)과 VCTK데이터셋 (109 English 44000 short audio clips), total 44hours, 16-bit pcm, 22kHz
Preprocessing: posterior encoder 입력으로는 FFT사이즈가 1024, 1024, 256으로 STFT를 이용한 linear spectrogram. reconstruction loss에서는 80 bands mael-scale. prior encoder 입력은 International Phonetic Alphabet (IPA).
Training: 전체 latent 대신 32 window size로 decoder에 넣음
4. Result
DDP는 stochastic duration predictor 대신 the same deterministic duration predictor architecture used in GlowTTS
Speech Synthesis Quality
Generalization to Multi-Speaker Text-to-Speech
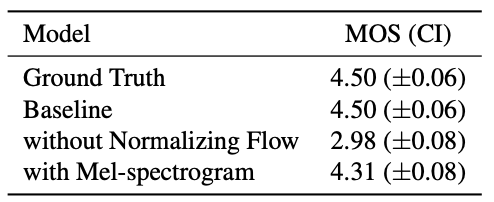
ablation studies 에서 FLOW를 빼니 확실히 성능이 떨어진다.
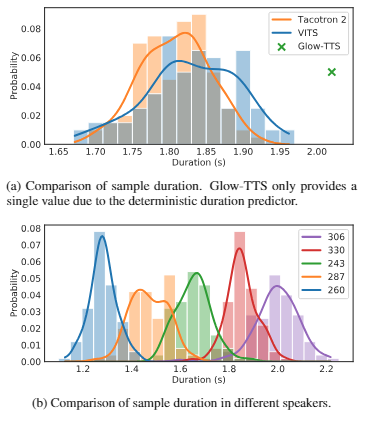
Speech Variation
모델별, speaker 별 duration
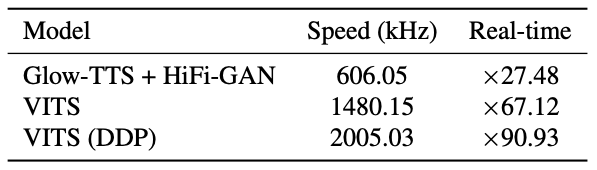
Synthesis Speed
single NVIDIA V100 GPU에서 합성 속도
not require modules for generating predefined intermediate representations라서 속도가 빠르다.
Duration Prediction in Non-Autoregressive Text-to-Speech
병렬모델은 대상 음소 길이나 전체 음성 길이를 예측해야되는데 음성 리듬의 joint 분포를 포착하기 어렵다. 그래서 flow-based stochastic duration predictor가 joint 분포를 병렬적으로 합성하기 좋다.