AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration
이 글의 목차
Abstract
in terms of memory size and bandwidth, pose significant deployment challenges.
그래서 본 논문에서는 Activation-aware Weight Quantization(AWQ)를 제안한다. AWQ는 하드웨어 친화적으로 low-bit weight-only quantization, 낮은 비트 가중치만 양자화하는 방법이다.
backpropagation 이나 reconstruction 관련은 아니지만 overfitting 없이 LLMs’ generalization ability on different domains and modalities를 보존했다. 더 나은 생성으로 인해 instruction-tuned LM과 multi-modal LM에 좋은 성능을 나타냈다.
또한 AWQ와 함께 TinyChat을 구현했는데, 이는 성능을 개선시킨 효율적이고 유연한 추론 프레임워크로써 데스크톱 및 모바일 GPU에서 Huggingface FP16 구현에 비해 3배 이상 빠른 속도를 제공한다. 그리고 모바일 GPU에 70B Llama-2 모델을 배포하는 것을 포용한다.
1. Introduction
큰 언어 모델들을 edge devices에 직접 배치하는 것 클라우드 서버로 데이터를 보내는 지연을 줄이고, 오프라인 상태에서 작동하게 하여 가상 비서, 챗봇, 자율주행 차량과 같은 실시간 애플리케이션에 유리하다. AWQ는 가장 중요한 가중치에 양자화를 건너뛰어 양자화 손실을 크게 줄이는 하드웨어 친화적 low-bit 가중치로 양자화하는 방법을 제안한다. 양자화 기술은 주로 Quantization-aware training(QAT)과 post-training quantization(PTQ) 두 가지 범주로 나뉘며, 대부분의 사람들이 LLMs를 양자화하기 위해 후자를 사용한다.
본 논문에서는 AWQ로, 하드웨어 친화적인 low-bit 가중치만 quantization을 제안하는데 이 방법은 LLM의 성능에 가중치가 똑같이 중요하지 않다는 관찰에 기반한다. 중요한 가중치에 작은 fraction을 사용하여 quantization loss를 상당히 줄였다. salient 가중치를 찾기위해 가중치 분포보다는 activation 분포를 더 선호했다. salient channels 를 확장하여 양자화 오류를 줄였다
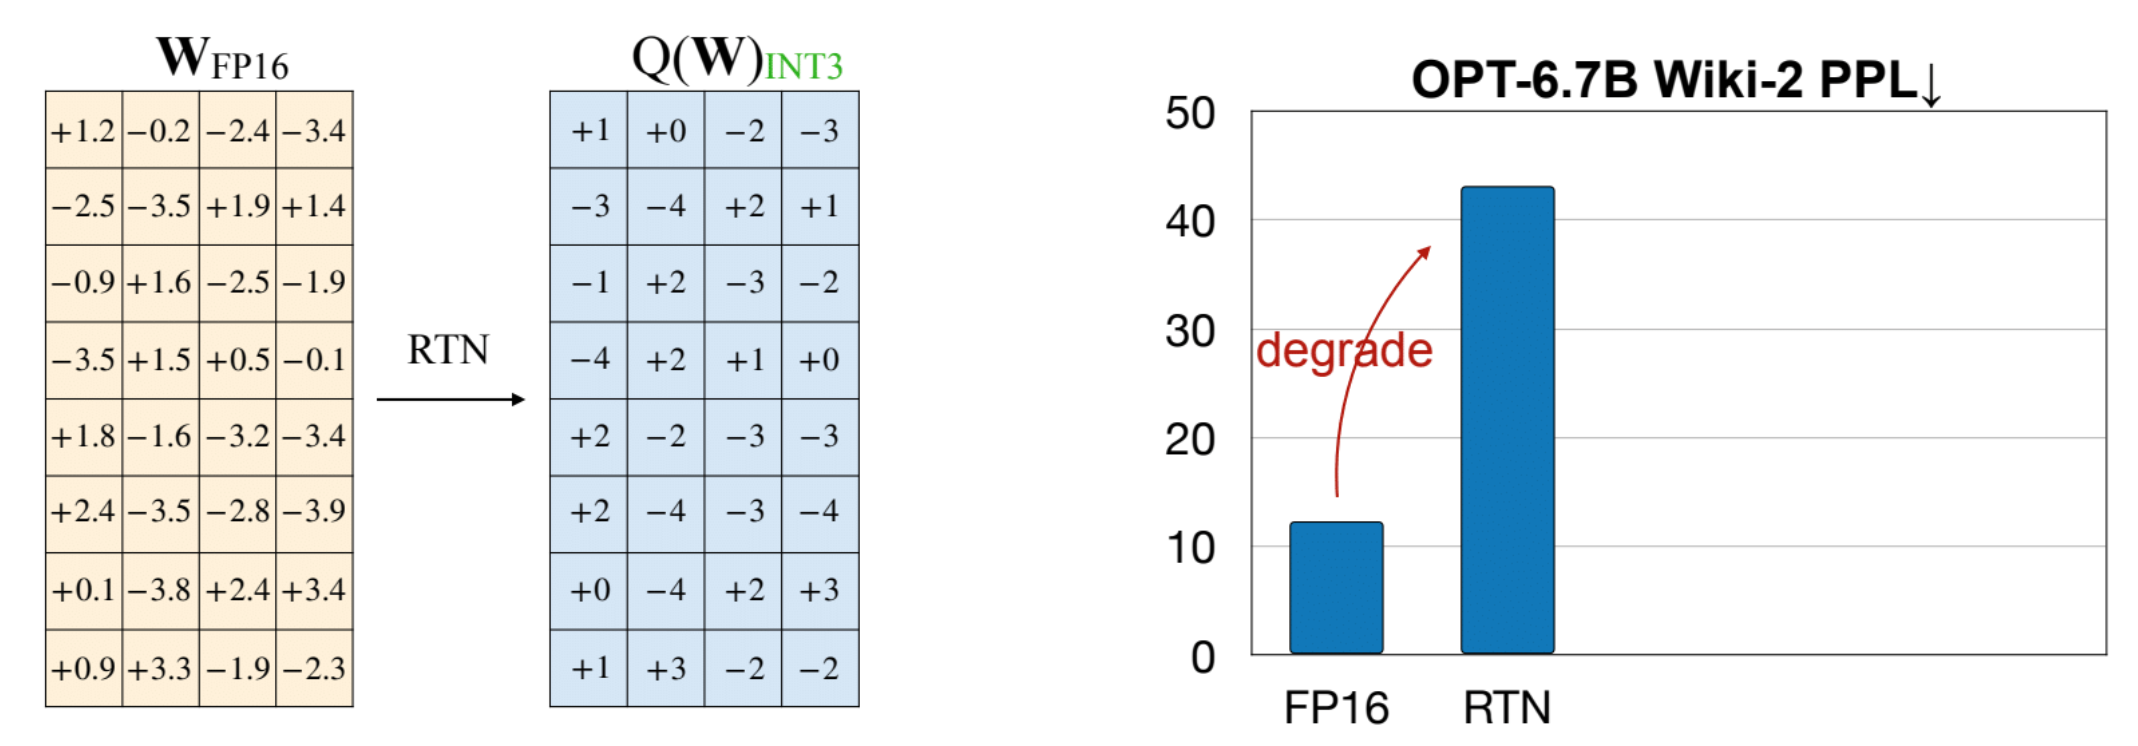
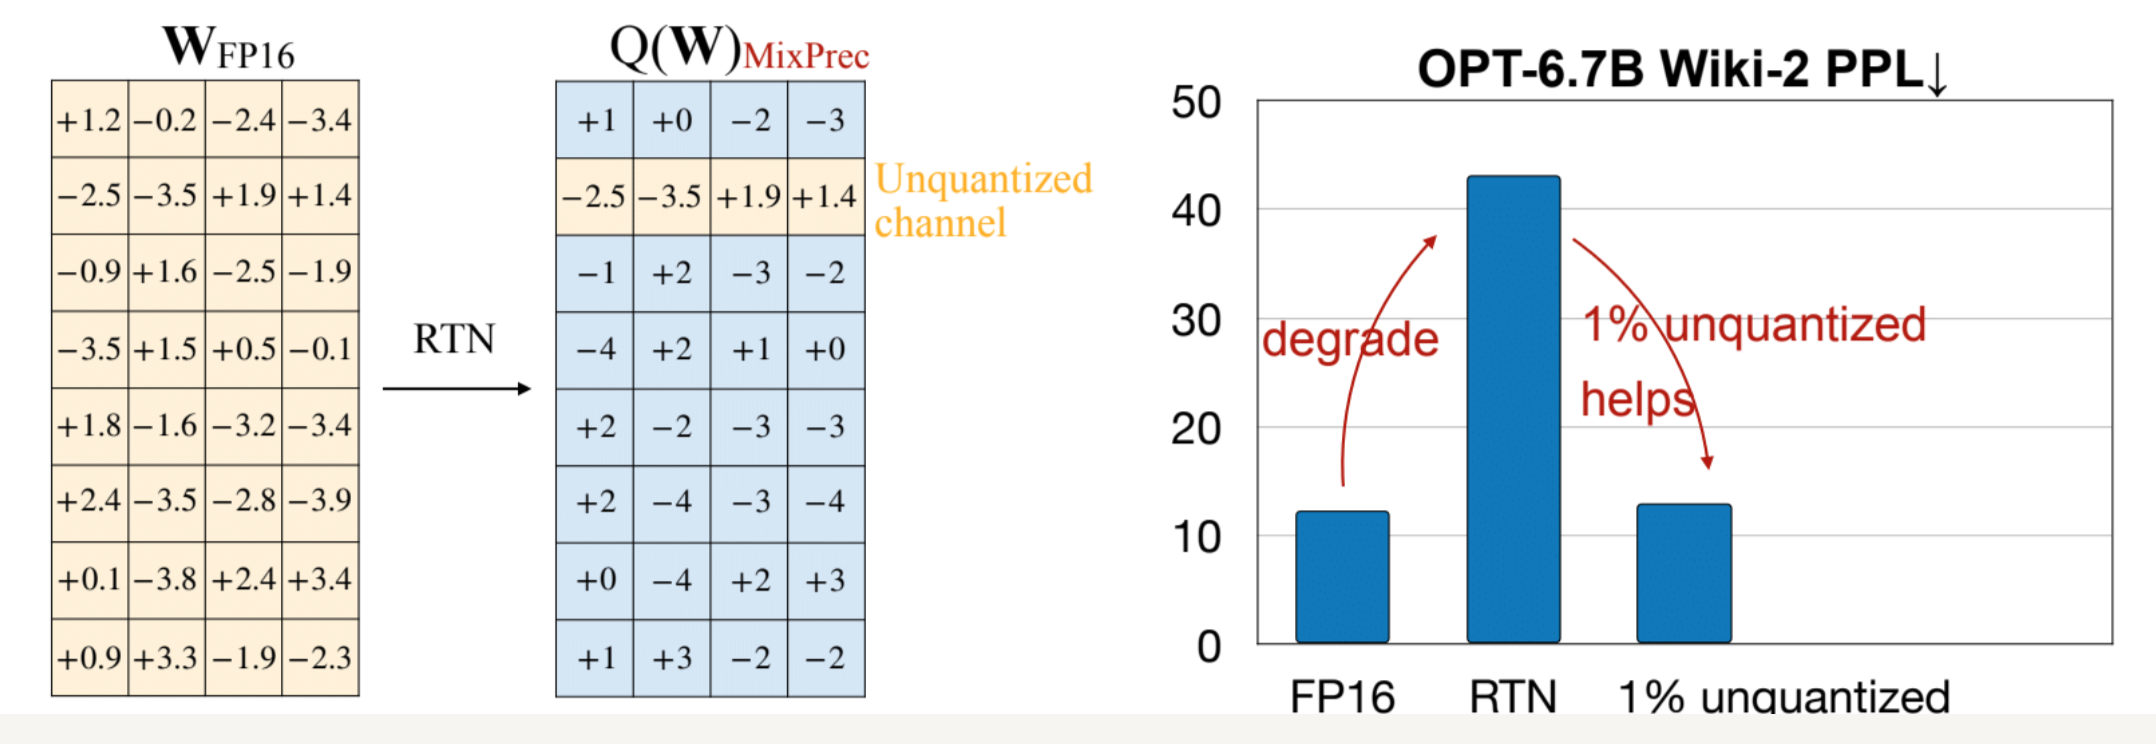
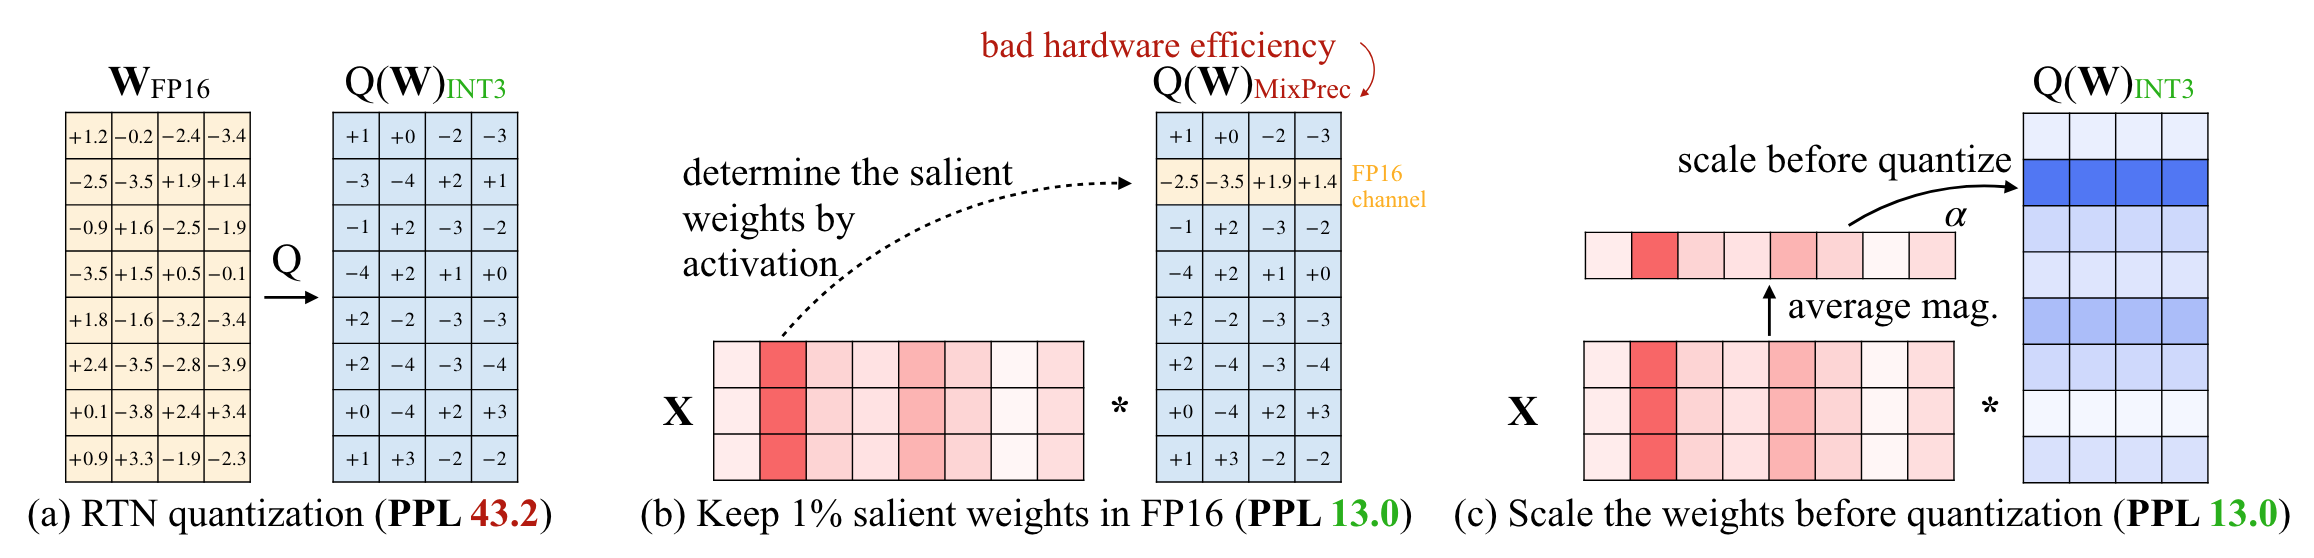
FP16 인 weight 값을 int3 으로 RTN quantization 할 경우 성능이 떨어지는데, 1~2% 정도의 salient weight부르는 일부분 가중치들을 FP16으로 유지하면 성능을 유지 할 수 있다. 그래서 이 salient weightd를 어떻게 결정하고, 어떻게 구현하나? mixed precision으로 찾거나 구현한다면 너무 효율이 떨어지므로 per-channel scaling라는 방식으로
salient channel 을 scaling factor 로 곱한 다음에 양자화 하고, 실제 activation 계산 시에는 마지막에 다시 scaling factor로 나눔
가중치 양자화와 정확도 향상 방법 설명
- 가중치 양자화는 부동 소수점을 낮은 비트 정수로 매핑하여 모델 크기와 추론 비용을 줄이는 효과적인 방법이다.
- 중요한 가중치를 보호하면서 정확도를 향상시키기 위한 가중치 전용 양자화 방법을 제안한다.
- 가중치의 L2-노름을 바탕으로 선택하는 것이 아닌, 활성화 크기에 따라 가중치를 선택하는 것이 양자화 성능을 크게 향상시키는 것을 확인했고, 이는 모델 성능을 개선하는데 기여한다.
- 필요한 중요한 가중치를 FP16로 유지하여 양자화 성능을 향상시키지만, 시스템 구현이 복잡해지므로 FP16로 유지하지 않고 중요한 가중치를 보호하는 방법이 필요하다.
가중치 만을 고려한 양자화'의 오차 분석
- 가중치만을 양자화 한 것에서 오차를 분석하자면, 가중치 w의 그룹/블록을 고려한다. 선형 연산은 y=wx로 쓰여지며, 양자화된 대응물은 y=Q(w)x이다.
- 특히, 양자화 함수는 Q(w) = ∆ · 반올림 (w / ∆), ∆ = |w|의 최댓값 2N−1에 의해 정의된다. 여기서 N은 양자화 비트의 수이며, ∆는 절대 최댓값에 따라 결정된 양자화 스케일러다.
- 가중치 요소 w∈w를 고려할 때, 만약 우리가 곱셈을 하게 되면 A WQ: On-Device LLM 압축 및 가속화를 위한 활성화 인식 가중치 양자화와 관련된 %(based on act.) FP16% (based on W) % (random) (w3-g128) 0.1% 1% 3% 0.1% 1% 3% 0.1% 1% 3% OPT-1.3B 14.62 119.00 25.03 16.91 16.68 108.71 98.55 98.08 119.76 109.38 61.49 OPT-6.7B 10.86 23.54 11.58 11.39 11.36 23.41 22.37 22.45 23.54 24.23 24.22 OPT-13B 10.13 46.04 10.51 10.43 10.42 46.07 48.96 54.49 44.87 42.00 39.71
Quantized 모델의 성능 향상에 기여하는 FP16의 중요성
- FP16 가중치의 소량(0.1%-1%) 유지는 양자화 모델의 성능을 개선시킴.
- 양자화된 모델의 성능을 향상시키려면, 중요한 FP16 가중치를 선택할 때 활성화 분포를 보는 것이 효과적.
- AWQ는 중요한 가중치 보호하고 양자화 오차를 줄이는데 효과적.
- S(스케일링)을 키울수록 중요한 채널이 향상되고, 최적의 성능은 s=2에서 나타남.
- Salient 채널 확장은 perplexity를 현저히 향상시키며, s가 커질수록 변화하는 Δ의 백분율이 증가함.
WQ: 활성화 인식 가중치 양자화 설비 LLM 압축 및 가속화
- LLM 압축 및 가속화를 위한 '활성화 인식 가중치 양자화'인 WQ에 대한 분석.
- Generation 단계의 속도가 느리며 메모리 대역폭에 의해 제한됨.
- W4A16 양자화가 적용되는 경우, 가중치접근량이 활성화 접근량보다 훨씬 많음.
- AWQ는 RTN보다 우수한 성능을 보이며 혼합 정밀도와 유사한 성능을 달성함.
- TinyChat은 AWQ 모델 추론을 위한 간소화된 시스템을 소개하며, CUDA/PTX, Neon, A VX와 같은 장치별 명령어 집합을 활용함.
온디바이스 LLM 가속화에 도움되는 WQ 이유
- LLM의 양자화된 가속화 기회를 이해하기 위해 LLaMA-7B 모델 프로파일링을 시작하고, RTX 4090 GPU에서 FP16로 모델을 구현하여 엣지 케이스를 고려한 추론 배치 사이즈 1을 사용했다.
- 레이턴시에서 가장 느린 단계는 생성 단계로, 20개의 토큰을 생성하는 데 310ms가 걸리지만, 200개의 토큰을 요약하는 것은 10ms만 소요된다. 이에 따라, 생성 단계는 특히 온디바이스 인터랙티브 애플리케이션에 있어 맥락 단계보다 상당히 느리다.
- 가속화를 위해 루프라인 분석을 실시하고, 4090 GPU의 메모리 대역폭을 고려하여 연산량 대 메모리 엑세스 비율이 165보다 낮으면 메모리 바운드라는 결론에 도달한다.
- AWQ는 가중치 메모리를 4배로 줄여 총 메모리 트래픽을 감소시키는 것으로, 온디바이스 LLM에는 가중치 엑세스이 메모리 트래픽을 지배함이 명확하다. 따라서 WQ는 가중치만 양자화하여 가중치 비트폭을 줄이는 것으로 LLM 애플리케이션에서 이러한 환경을 따른다.
TinyChat을 활용한 가벼운 가중치 양자화 및 성능 향상
- 4-bit 가중치 양자화는 4배 이론적인 최고 성능을 이끌어냄.
- TinyChat은 주로 필수 구성 요소를 구현하는데 초점을 맞춤. AWQ를 사용한 TinyChat은 다양한 LLM 패밀리에서 Huggingface FP16 구현과 비교해 GPU에서 3배 이상의 속도 향상을 달성.
- INT4와 FP16 간의 곱셈 명령이 없기 때문에, 정수를 FP16로 해체하는 것이 필요.
- 단지 3개의 SIMD 명령이 필요한 ARM CPU에 대한 가중치 포장 방법이 32개의 4비트 가중치를 모두 해체할 수 있으므로 기존 포장과 비교해 여러모로 효율적임.
- 다양한 LLM 추론을 최적화하기 위해 다양한 커널 융합을 활용. 기존 커널 호출 수를 줄이는 것이 속도 향상으로 이어지는 점을 강조.
실험과 설정접기
- 이 작업에서는 가중치만을 그룹화된 양자화에 중점을 두었다.
- 그룹화된 양자화는 항상 성능/모델 크기 트레이드오프를 개선하는 데 도움이 된다.
- 작업 중에는 128의 그룹 크기를 사용했으며, INT4/INT3 양자화에 중점을 두었다.
- 또한 AWQ에 대해 사용된 작은 캘리브레이션 세트는 Pile에서 제공되었다.
AWQ 가중치 양자화와 성능 비교
- AWQ는 RTN 및 GPTQ 대비 양자화 성능을 지속적으로 향상시켰다.
- AWQ는 LLM 모델에서 GQA 및 MoE 모델을 포함해 다양한 구조에 뛰어난 양자화 성능을 제공한다.
- 양자화된 모델의 성능을 봤을 때, AWQ가 일반적으로 설계된 모델에 대한 탁월한 일반화 성능을 보여준다.
- 이를 통해 AWQ는 GPTQ-Reorder 또는 GPTQ-R과 같은 기술적인 방법들에 비해 효율적으로 대규모 모델에 적용 가능하며, 성능 면에서 뛰어나다.
양자화 및 모델 성능평가
- LLaMA 모델인 LLaMA와 Llama-2의 우수한 성능에 초점 (Zhang et al., 2022; Scao et al., 2022) 추후 타 모델과 비교.
- Mistral / Mixtral 모델에도 AWQ 평가 (Jiang et al., 2023), 모델 축소 및 성능 유지 테스트.
- VILA-7B 및 VILA-13B에 AWQ 적용 결과, 모든 벤치마크에서 성능 유지 확인. (Lin et al., 2024)
- 명령어 튜닝 모델의 양자화 테스트 결과, Vicuna 모델 성능 향상 확인. (Chiang et al., 2023)
멀티 모달 언어 모델의 양자화 및 성능 개선 연구
- 대규모 멀티 모달 모델(LMMs)인 VLMs는 시각 입력을 포함한 LLMs로, 이미지/비디오 입력에 의존하는 텍스트 생성이 가능하다.
- AWQ는 프로그래밍 및 수학 데이터셋에서 기존 방법보다 우수한 성과를 거두며 복잡한 생성 작업에도 적합성을 입증한다.
- INT2로 LLM 양자화하여 기기 메모리 한곗값 고려하며 AWQ는 GPTQ와 결합하여 INT2 양자화 성능을 현저히 향상시킨다.
- AWQ는 VILA를 포함한 최신 멀티 이미지 비주얼 언어 모델에 대해 무손실 양자화 성과를 보여주고, RTN에 비해 우위를 갖는다.
- LLaV A-13B 모델의 시각적 추론 예제를 통해, INT4-g128 양자화에서 AWQ가 RTN에 비해 더 합리적인 답변을 제공함을 입증한다.
데이터 효율성과 일반화
- 우리 방법론은 회귀/백프로파게이션에 의존하지 않아 더 나은 데이터 효율성을 갖고 있다. 평균 활성화 스케일만을 측정하므로 더 적은 캘리브레이션 세트가 필요하다.
- AWQ는 INT3-g128 양자화와 비교하여, OPT-6.7B 모델의 퍼플렉서티를 비교함(그림 8(a)). AWQ는 더 작은 캘리브레이션을 필요로 한다.
- 우리 방법은 캘리브레이션 세트 분포에 대해 더 강건 한 경향을 보인다. Pile 데이터 세트의 서브셋을 사용하여 효과를 검증했으며(PubMed 및 Enron), 동일한 캘리브레이션 및 평가 분포를 사용할 때 가장 잘 작동하는 것을 확인하였다.
- 다양한 캘리브레이션 세트 분포의 효과를 벤치마킹하여 AWQ는 GPTQ와 비교해 캘리브레이션 세트 배포에 덜 민감 하며 더 나은 퍼플렉서티를 제공한다.
TinyChat 시스템 가속화 결과 및 비교
- TinyChat은 RTX 4090 및 A100 4090 Orin에서 VILA-7B 및 VILA-13B를 최대 3.1배 및 2.9배 가속화시킨다.
- TinyChat은 Jetson Orin에서 LLM에 2.7-3.9배 속도 향상을 제공하며, 다양한 모델을 지원하고 Raspberry Pi 4B에 7B 모델을 0.7 tokens/s로 배포한다.
- 기존 시스템(AutoGPTQ, llama.cpp, exllama) 대비 TinyChat은 1.7배 속도 향상을 제공하며, LLaMA 및 Llama-2 모델 외에도 StarCoder, StableCode, Mistral, Falcon에 대해 유연한 적응성을 보여준다.
- TinyChat은 다양한 GPU 구조에서 AWQ 모델을 위한 PyTorch API를 사용하여 탁월한 확장성을 제공한다.
AWQ: On-Device LLM 압축 및 가속화를 위한 활성화-인식 가중치 양자화
- AWQ는 저비트 가중치만 사용하는 LLM을 위한 간단하고 효과적인 방법으로, 가중치가 모두 동등하게 중요하지 않다는 관찰에 기초하여, 중요한 가중치의 양자화 손실을 줄이기 위해 채널 단위로 스케일링을 수행한다.
- AWQ는 보존력 있는 LLM의 일반 능력을 유지하며 보강되었으며, 지시어에 맞는 LMs 및 다중 모달 LM에 적용 가능하며, 기존 작업보다 언어 모델링에서 성능이 우수하다.
- TinyChat 시스템은 AWQ로 달성한 이론적 메모리 절약을 활용하여 Huggingface의 FP16 구현체에 비해 데스크톱 및 모바일 GPU에서 3.2-3.3배 속도 향상을 실현함으로써 LLM 배포의 민주화를 이룬다.
- 참고문헌으로는 Alayrac 등(2022), Austin 등(2021), Awadalla 등(2023), Bengio 등(2013) 등이 있으며, 관련 URL에는 다수의 논문 자료가 나열되어 있다.
효율적인 신경망을 위한 가중치와 연결
- 진보된 신경 정보 처리 시스템 및 기술 (NIPS) 28 회 (2015).
- 한, 고급, 그리고 Dally, W. J. Deep Compression: 절삭, 훈련된 양자화와 허프만 부호를 사용하여 딥 네트워크 압축.(ICLR, 2016).
- Hudson, D. A. 그리고 Manning, C. D. Gqa: 현실 세계 시각 추론과 복합 질문 응답을 위한 새로운 데이터세트. (CVPR, 2019).
- Jacob, B., Kligys, S., Chen, B., Zhu, M., Tang, M., Howard, A., Adam, H., 그리고 Kalenichenko, D. Quantization 및 효율적인 정수-산술만 추론을 위한 신경망 훈련. IEEE 컴퓨터 비전 및 패턴 인식 학회 논문집, WQ: 장치 내 LLM 압축 및 가속화를 위한 활성화 인식 가중치 양자화를 위한 활성화 양자화 및 가중치 국제 컨퍼런스에서, pp. 2704-2713, 2018.
- Jiang, A. Q., Sablayrolles, A., Mensch, A., Bamford, C., Chaplot, D. S., Casas, D. d. l., Bressand, F., Lengyel, G., Lample, G., Saulnier, L., 외. Mistral 7b. arXiv 사전 인쇄, arXiv:2310.06825, 2023.
인공지능과 머신러닝 관련 논문 인용
- 전문가들의 W. E. Mixtral 논문, 2024년.
- Kim, Y . J., Henry, R., Fahim, R., Awadalla, H. H.의 '코닥스 대규모 모델' 논문, 2022년.
- Koh, J. Y ., Salakhutdinov, R., Fried, D.의 '마개 모델의 이미지 접속' 논문, 2023년.
- Li, Y ., Gong, R., Tan, X., Yang, Y ., Hu, P., Zhang, Q., Yu, F., Wang, W., Gu, S.의 'Brecq' 논문, 2021년.
- Lin, J., Chen, W.-M., Lin, Y ., Gan, C., Han, S. 등의 'Mcunet' 논문, 특히 IoT 기기에서의 작은 딥 러닝 논문.
연구논문 인용: 컴퓨터 비전 및 자연어 처리 모델에 대한 연구접기
- 2020년 출판된 Lin 등의 논문 'Vila: 시각 언어 모델을 위한 사전 훈련' 소개.
- 2022년 발표된 Lu의 논문 '과학 질문에 대한 다중 모달 추론을 통한 설명 학습' 소개.
- 2019년 IEEE/CVF 국제 컴퓨터 비전 학회에서 발표된 Nagel 등의 '데이터 무관한 양자화를 위한 가중치 등화 및 편향 보정' 논문 소개.
- 2023년 MLC-Team의 'MLC-LLM'과 관련된 논문 소개.
- 2022년 발표된 Ouyang의 논문 '인간 피드백을 통한 지시에 따른 언어 모델 훈련' 소개.
논문 목록 요약
- Park 등. (2022)은 대규모 생성 언어 모델의 효율적 추론을 위한 양자화된 매트릭스 연산에 대해 다룸.
- Penedo 등. (2023)은 Falcon LLM을 위한 refinedweb 데이터셋 생성에 관해 다루며, 웹 데이터만을 이용해 curated corpora를 능가함.
- Sanh 등. (2021)은 장치 내 LLM 압축과 가속을 위한 활성화 인식 가중치 양자화에 대해 다룸.
- Scao 등. (2022)은 176b-매개변수 다국어 언어 모델 'Bloom'에 대한 연구를 소개함.
- Sheng 등. (2023)은 하나의 GPU로 대규모 언어 모델의 생성 추론을 고속화하는 연구에 대해 다룸.
ref
- Tillet, P., 등의 연구 논문(2019) 소개
- Touvron, H., 등의 논문(2023a, 2023b) 소개
- Vaswani, A., 등의 논문(2017)에서 'Attention is all you need' 소개
- Wang, H., 등의 논문(2020, 2019) 소개
- Wei, J., 등의 논문(2021, 2022a, 2022b, 2023) 소개
- Xiao, G., 등의 논문(2022) 소개
- Yao, Z., 등의 논문(2022) 소개
- Yu, W., 등의 논문(2023) 소개
- Zhang, R., 등의 논문(2023) 소개
- Zhang, S., 등의 논문(2022) 소개
- 이 방법은 관찰을 기반으로 한다: 가중치가 모두 중요하지 않다는 것을 생각하고, 중요한 가중치의 1%만 보호하면 양자화 오류를 크게 줄일 수 있다고 제안했다.
- 이로 인해 AWQ는 다양한 언어 모델링과 도메인 특정 벤치마크에서 우수한 성능을 보이며, 지시어에 튜닝된 LMs 및 처음으로 다중 모달 LMs에 대한 우수한 양자화 성능을 달성했다.
- 또한 AWQ와 함께 TinyChat을 구현했는데, 이는 성능을 개선시킨 효율적이고 유연한 추론 프레임워크로써 데스크톱 및 모바일 GPU에서 Huggingface FP16 구현에 비해 3배 이상 빠른 속도를 제공한다. 그리고 모바일 GPU에 70B Llama-2 모델을 배포하는 것을 포용한다.