Efficient Memory Management for Large Language Model Serving with PagedAttention
LLM 서빙에서 KV 캐시의 메모리 낭비를 줄이는 PagedAttention을 살펴봅니다. vLLM의 메모리 관리 방식과 처리량 개선의 핵심을 정리합니다.
계속 읽기양자화와 메모리 관리 등 LLM 추론 효율화 논문 리뷰
모든 태그 보기LLM 서빙에서 KV 캐시의 메모리 낭비를 줄이는 PagedAttention을 살펴봅니다. vLLM의 메모리 관리 방식과 처리량 개선의 핵심을 정리합니다.
계속 읽기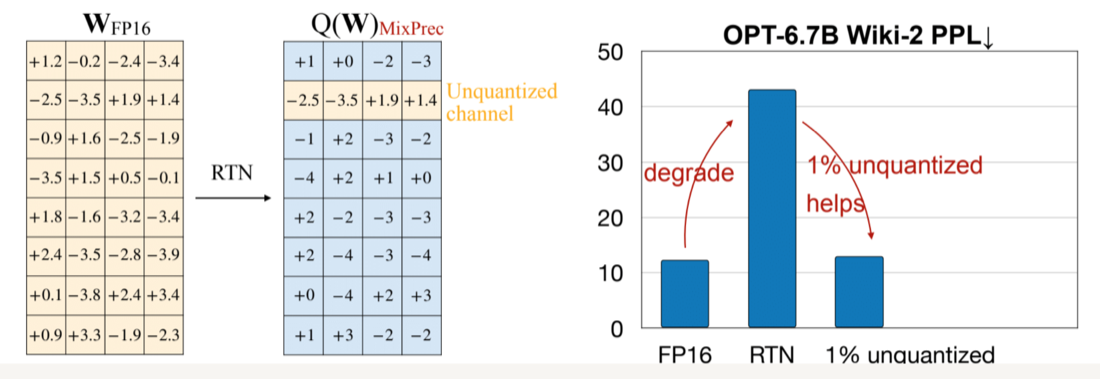
활성화 정보를 활용해 중요한 가중치를 보호하는 AWQ를 살펴봅니다. 낮은 비트의 가중치 양자화로 LLM의 메모리 사용량과 추론 비용을 줄이는 방법을 정리합니다.
계속 읽기