Efficient Memory Management for Large Language Model Serving with PagedAttention
LLM 서빙에서 KV 캐시의 메모리 낭비를 줄이는 PagedAttention을 살펴봅니다. vLLM의 메모리 관리 방식과 처리량 개선의 핵심을 정리합니다.
Continue ReadingLLM 서빙에서 KV 캐시의 메모리 낭비를 줄이는 PagedAttention을 살펴봅니다. vLLM의 메모리 관리 방식과 처리량 개선의 핵심을 정리합니다.
Continue Reading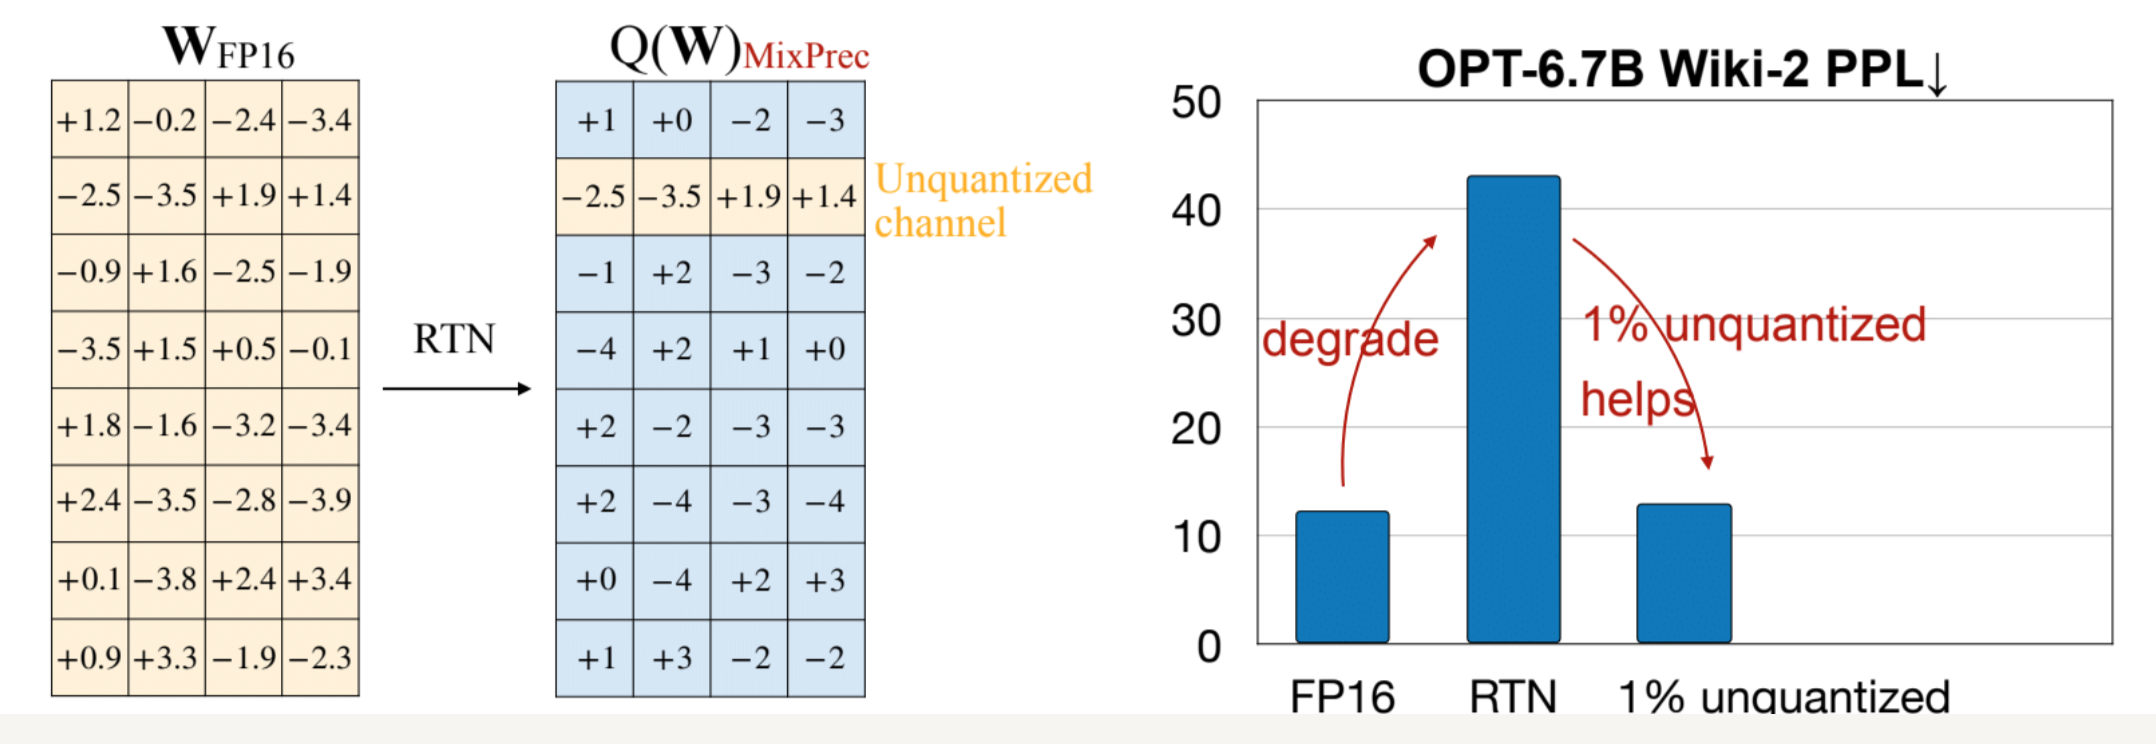
활성화 정보를 활용해 중요한 가중치를 보호하는 AWQ를 살펴봅니다. 낮은 비트의 가중치 양자화로 LLM의 메모리 사용량과 추론 비용을 줄이는 방법을 정리합니다.
Continue Reading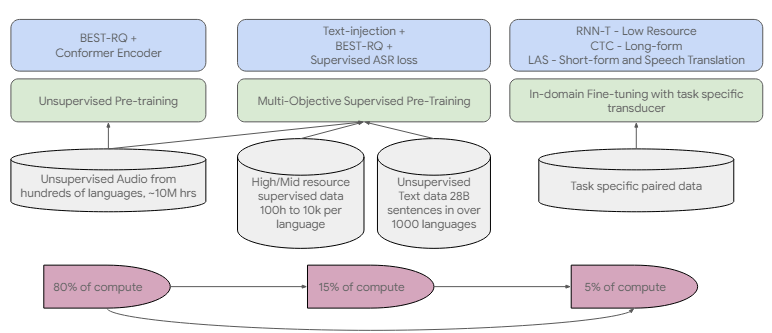
100개 이상의 언어를 다루는 Google USM의 음성 인식 접근법을 살펴봅니다. 대규모 음성 사전학습과 다국어 확장의 핵심 아이디어를 정리합니다.
Continue Reading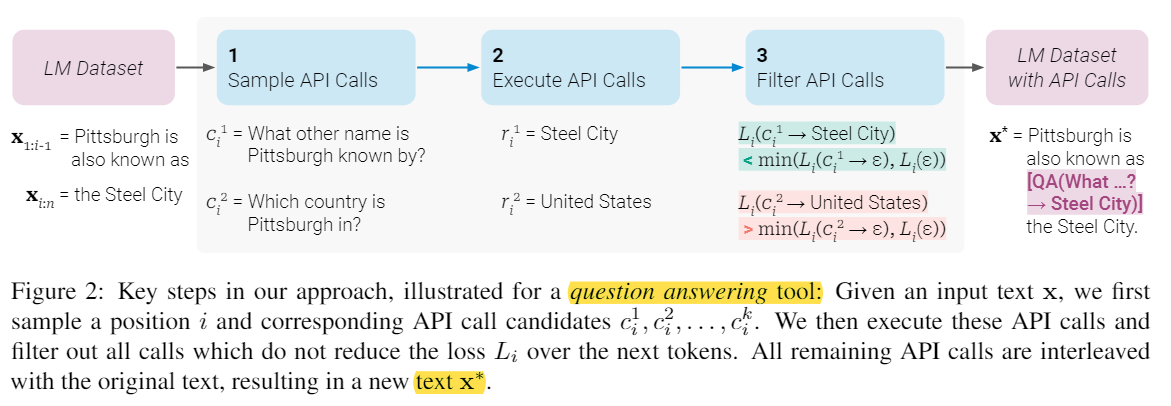
언어 모델이 외부 도구의 호출 시점과 사용법을 스스로 학습하는 Toolformer를 살펴봅니다. API 호출 데이터를 구성하고 학습에 활용하는 과정을 정리합니다.
Continue Reading
손상된 텍스트를 복원하며 사전학습하는 BART를 살펴봅니다. 양방향 인코더와 자기회귀 디코더를 결합한 구조 및 텍스트 생성 적용을 정리합니다.
Continue Reading
OpenAI's Whisper model for robust speech recognition using 680,000 hours of weak supervision data
Continue Reading