Efficient Memory Management for Large Language Model Serving with PagedAttention
LLM 서빙에서 KV 캐시의 메모리 낭비를 줄이는 PagedAttention을 살펴봅니다. vLLM의 메모리 관리 방식과 처리량 개선의 핵심을 정리합니다.
계속 읽기ML·NLP, 언어 모델, 추론 효율화, 음성 연구 논문을 읽고 정리합니다.
연도별 아카이브 보기LLM 서빙에서 KV 캐시의 메모리 낭비를 줄이는 PagedAttention을 살펴봅니다. vLLM의 메모리 관리 방식과 처리량 개선의 핵심을 정리합니다.
계속 읽기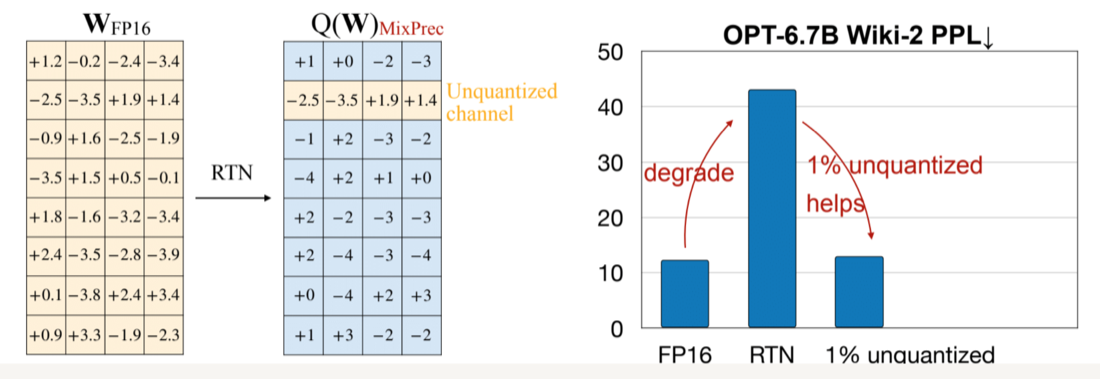
활성화 정보를 활용해 중요한 가중치를 보호하는 AWQ를 살펴봅니다. 낮은 비트의 가중치 양자화로 LLM의 메모리 사용량과 추론 비용을 줄이는 방법을 정리합니다.
계속 읽기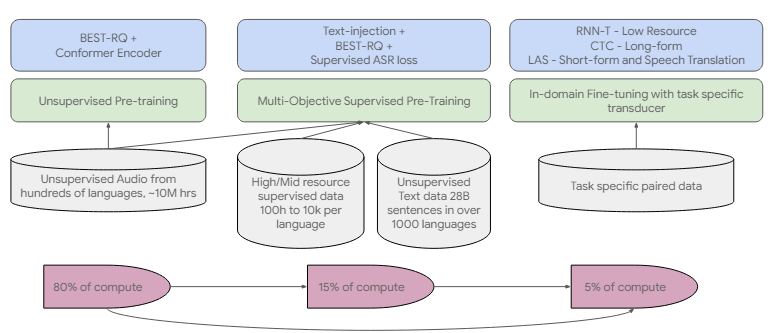
100개 이상의 언어를 다루는 Google USM의 음성 인식 접근법을 살펴봅니다. 대규모 음성 사전학습과 다국어 확장의 핵심 아이디어를 정리합니다.
계속 읽기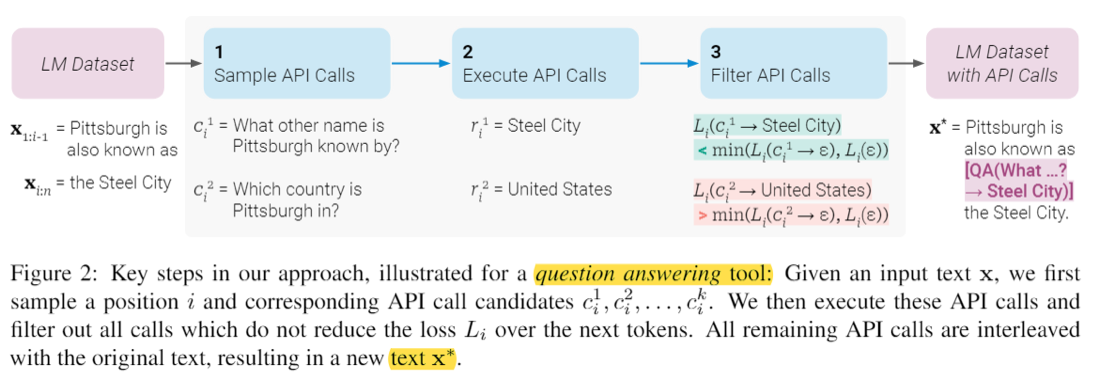
언어 모델이 외부 도구의 호출 시점과 사용법을 스스로 학습하는 Toolformer를 살펴봅니다. API 호출 데이터를 구성하고 학습에 활용하는 과정을 정리합니다.
계속 읽기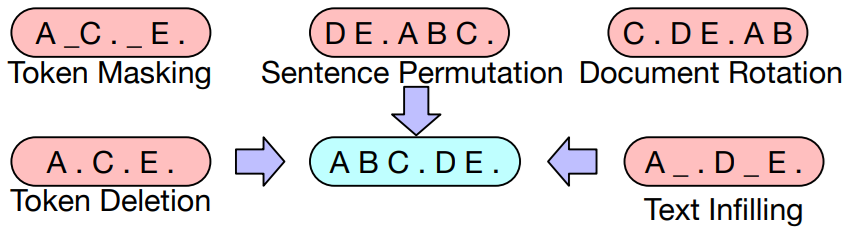
손상된 텍스트를 복원하며 사전학습하는 BART를 살펴봅니다. 양방향 인코더와 자기회귀 디코더를 결합한 구조 및 텍스트 생성 적용을 정리합니다.
계속 읽기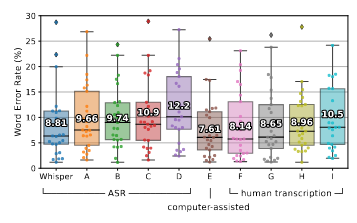
68만 시간 규모의 약지도 데이터로 학습한 Whisper를 살펴봅니다. 다국어·멀티태스크 학습으로 견고한 음성 인식을 얻는 방법을 정리합니다.
계속 읽기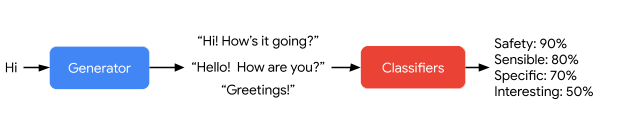
대화용 언어 모델 LaMDA의 학습과 평가를 살펴봅니다. 대화 품질, 안전성, 외부 정보에 근거한 응답을 위한 접근을 정리합니다.
계속 읽기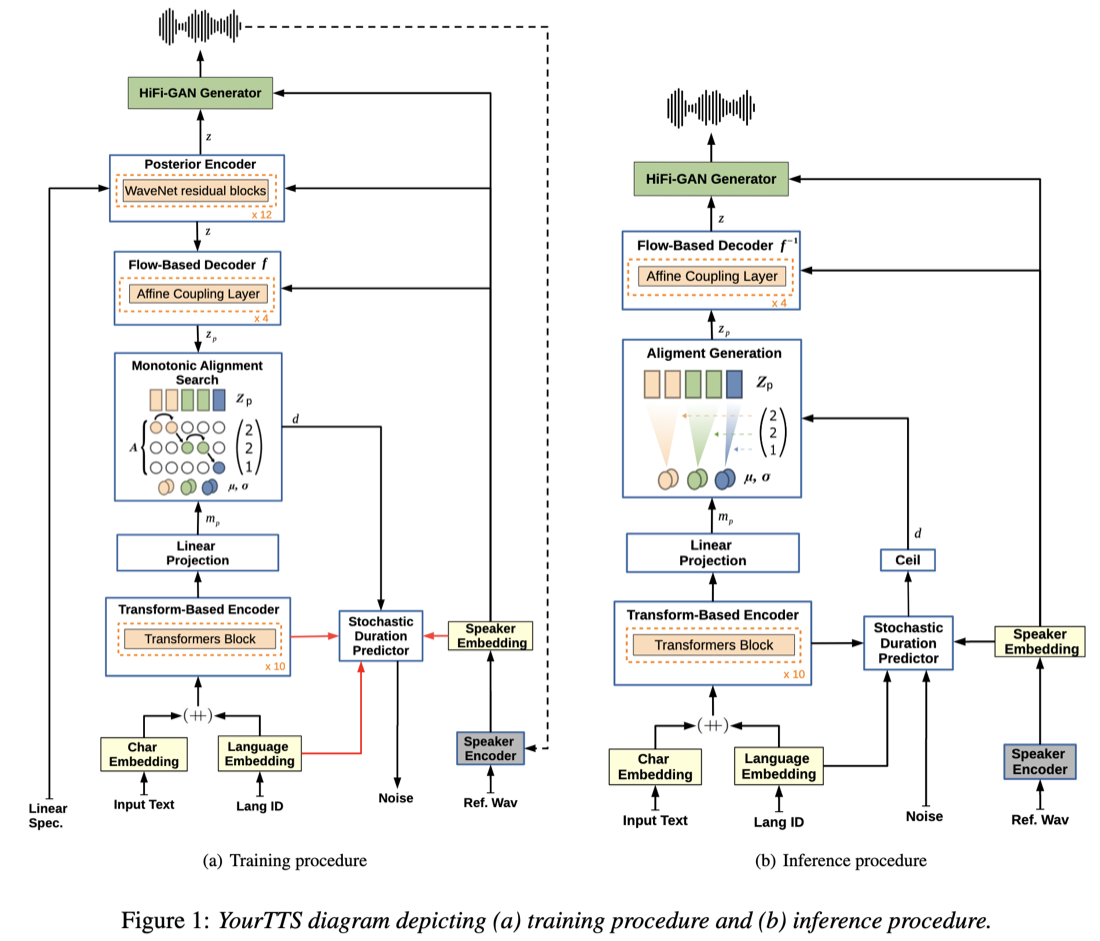
새로운 화자의 음성을 적은 참조 음성으로 합성하는 YourTTS를 살펴봅니다. 다국어·다화자 학습과 제로샷 음성 변환의 접근을 정리합니다.
계속 읽기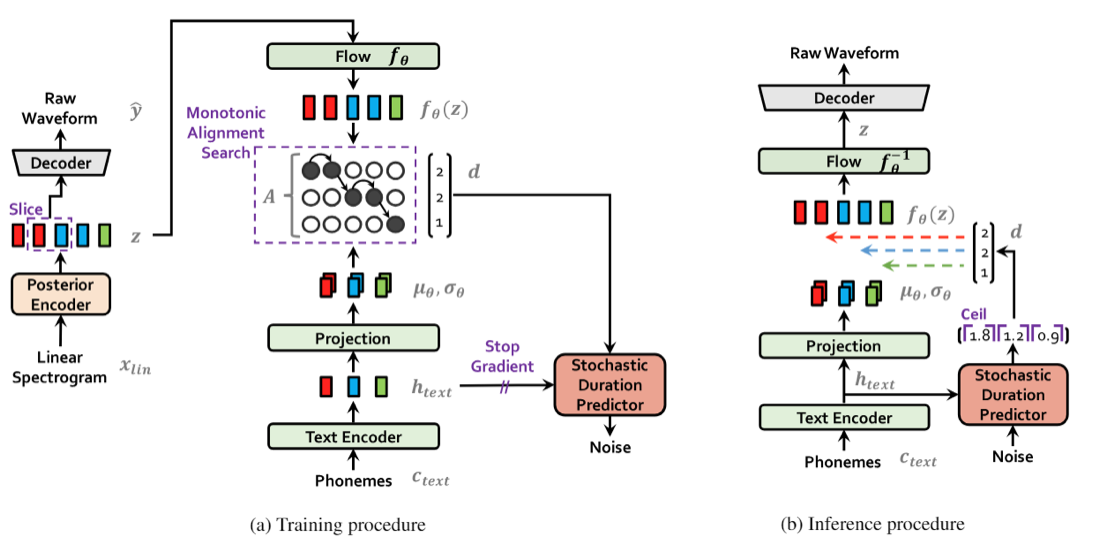
변분 추론과 적대적 학습을 결합한 end-to-end 음성 합성 모델 VITS를 살펴봅니다. 조건부 VAE와 정규화 흐름 기반 구조를 정리합니다.
계속 읽기
텍스트 설명에서 이미지를 생성하는 DALL-E를 살펴봅니다. 텍스트와 이미지 토큰을 함께 모델링하는 접근을 정리합니다.
계속 읽기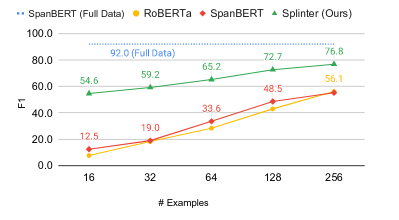
적은 수의 예제로 질문 응답을 학습하는 Splinter를 살펴봅니다. 반복되는 스팬을 활용한 사전학습 과제와 스팬 선택 방법을 정리합니다.
계속 읽기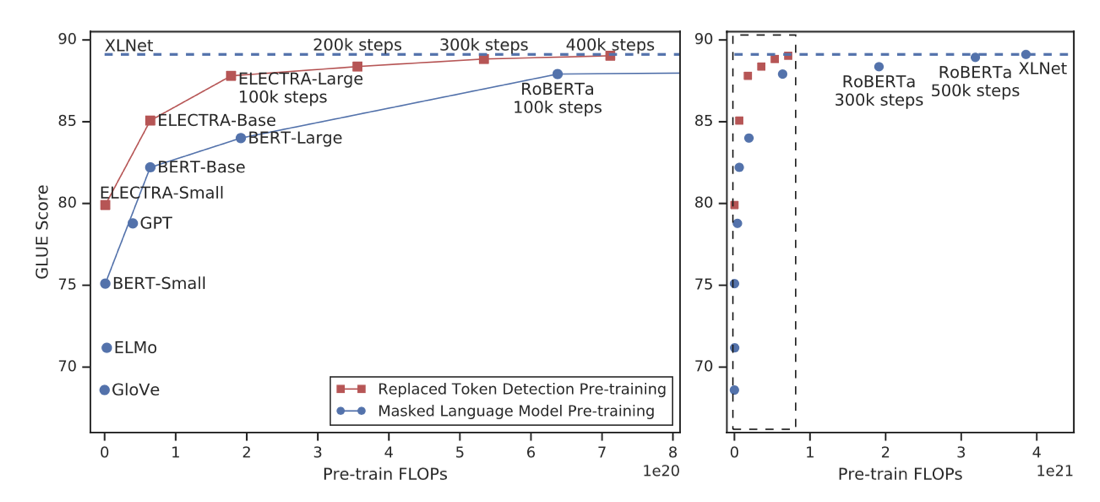
토큰을 생성하는 대신 교체된 토큰을 판별하며 학습하는 ELECTRA를 살펴봅니다. 생성기와 판별기를 활용한 효율적인 언어 모델 사전학습을 정리합니다.
계속 읽기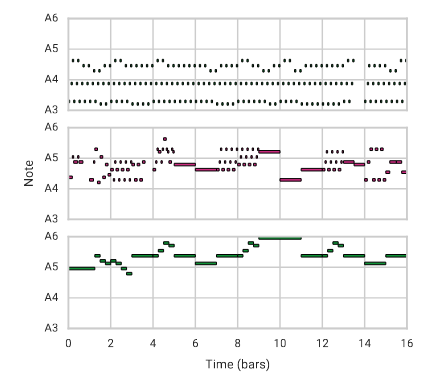
음악의 장기적인 구조를 학습하는 MusicVAE를 살펴봅니다. 계층적인 디코더와 잠재 공간을 활용한 음악 생성 방법을 정리합니다.
계속 읽기
Transformer의 어텐션 구조와 이를 바탕으로 한 BERT를 살펴봅니다. 셀프 어텐션, 위치 인코딩, 사전학습 방식을 정리합니다.
계속 읽기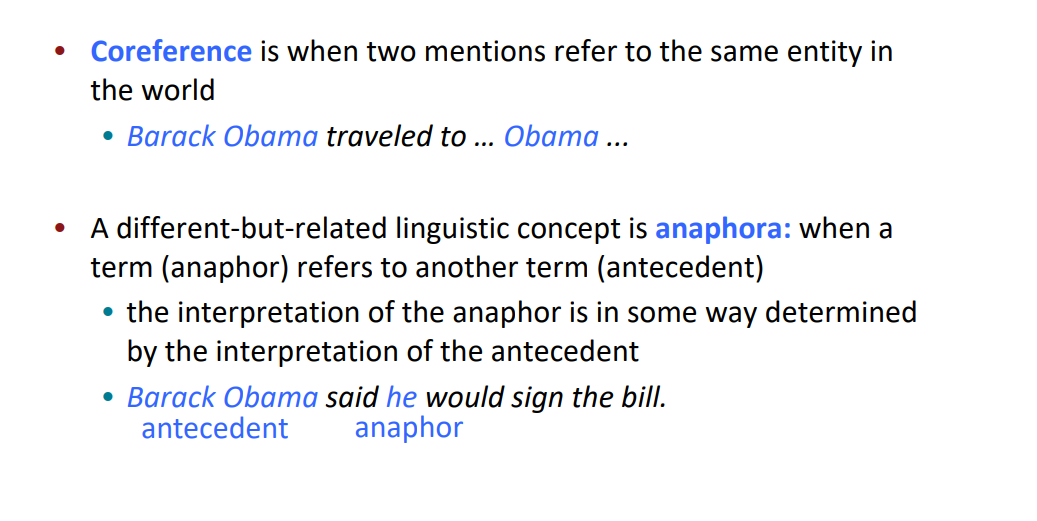
문서에서 같은 대상을 가리키는 표현을 연결하는 신경망 기반 상호참조 해결을 살펴봅니다. 스팬 표현과 선행사 예측의 핵심 아이디어를 정리합니다.
계속 읽기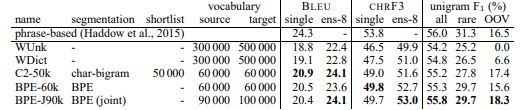
희귀 단어와 미등록 단어를 다루기 위한 서브워드 기반 번역을 살펴봅니다. BPE로 단어를 작은 단위로 나누는 방법과 효과를 정리합니다.
계속 읽기