MusicVAE: A Hierarchical Latent Vector Model for Learning Long-Term Structure in Music
VAE(Variational Auto-Encoder)는 seqeunces를 사용하는 long-term 구조에 사용하기어렵다.
그래서 outputs의 embeddings을 각 subsequence 에 독립적으로 생성하기 위하여 사용하는 hierarchical decoder 구조를 제안한다.
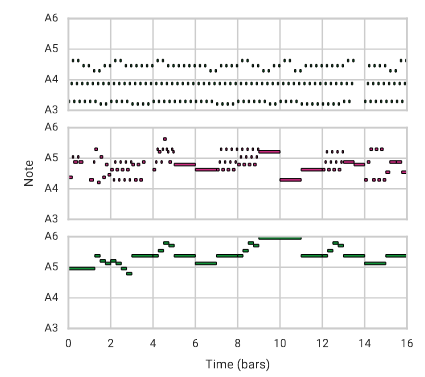
emonstration of latent-space averaging usingMusicVAE.
생성모델 GANs이나 autoregressive 모델인 PixelCNN, WaveNet 등은 우도 p(z|x)와 p(z)를 모두 명시적으로 모델링한다. 아직 continuous-valued data에서 deep letent variable models은 아직 long sequence에 성공적으로 적용하지 못했지만 짧은 seqeunce에는 잘 적용되는 걸 보여준다. musicVAE는 전체 sequence를 single letent vector로 표현한다 (accurately reconstruct)
posterior inference는 p(z|x)를 maximizing the evidence lower bound (ELBO)를 최대화 함으로써 KL deviergence를 최소화한다. prior p(z)는 diagonal-covariance Gaussian로 z ∼ N (μ, σI) 로 근사하여 계산된다 ε ∼ N (0, I), z = μ + σ ε ELBO는 E[log pθ (x|z)] and KL(qλ(z|x)||p(z))