ELECTRA: Pre-training Text Encoders as Discriminators Rather Than Generators
이 글의 목차
ELECTRA : PRE-TRAINING TEXT ENCODERS AS DISCRIMINATORS RATHER THAN GENERATORS
Masked language modeling(MLM)들은 일반적으로 많은 양의 계산을 필요로한다. 그에 대한 대안으로 이 논문은 replaced token detection이라고도 하는 pre-training을 효율적으로 하는 것에 의의를 둔다. 입력을 masking 하는 대신 작은 generator 모델을 통해 생성된 토큰으로 대체한다. 그래서 corrupted 토큰들의 원본을 예측하는 대신 이 토큰이 생성된 토큰인지 아닌지를 분별한다.
그래서 BERT와 똑같은 모델 사이즈, 데이터, 학습양으로 더 뛰어난 성능을 보여지고, RoBERTa나 XLNet 보다 1/4의 계산량으로 비슷한 결과를 보여주고 같은 계산량이면 더 능가한다.
intro
현재 다양한 언어모델들은 denoising autoencoders로 보여진다. 이 때 보통 15%의 입력에 mask를 하거나 이 토큰에 attention을 한다. 그 후 Bart같은 모델들은 sentence 순서를 바꾸고 span자체를 바꾸기도 한다~ 그래서 이 토큰들을 recover하는 방식으로 학습을 진행한다. 이에 대한 대안으로 replaced token detection을 목적으로 일제 입력과 생성해서 대체된 토큰들을 구별하는 것을 학습한다. 대체된 토큰들은 마스킹 대신 작은 MLM에서 proposal distribution으로 부터 나온 토큰들이다.
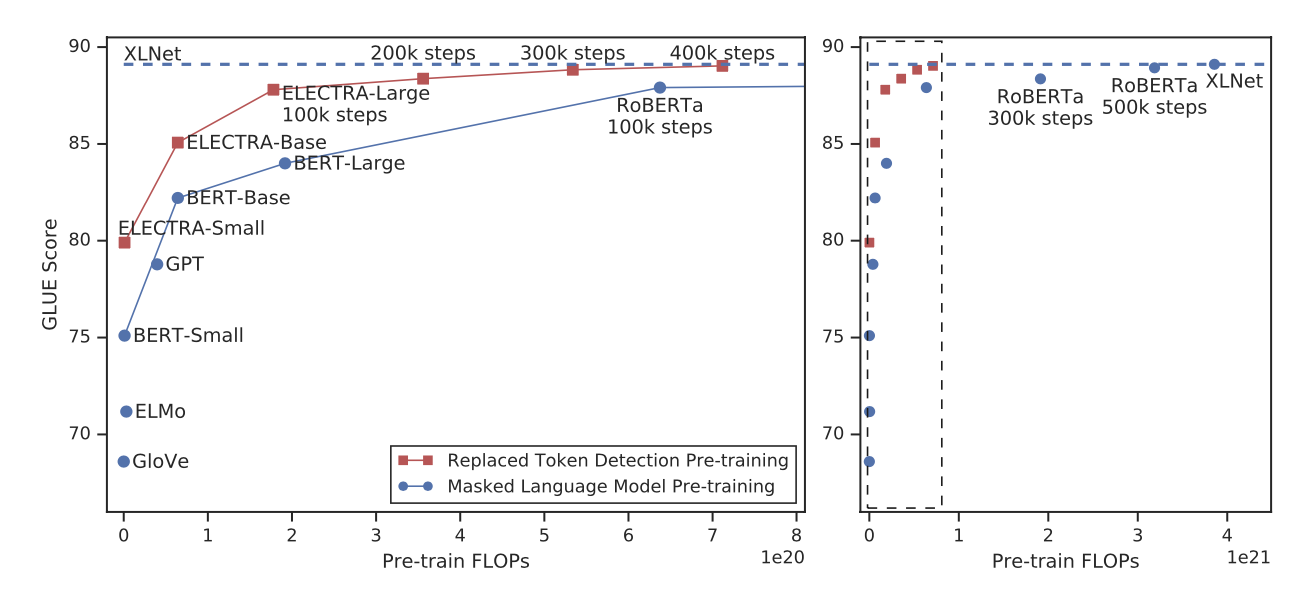
이 과정은 GAN과 비슷해보일수도 있으나, generator는 text에 적용하기 어려워서 maximum likelihood로 훈련되기 때문에 adversarial 방법은 아니다(Language GANs Falling Short) 그래서 결국 1/4의 계산량으로 ALBERT보다 성능이 뛰어났고 이 당시의 SQUAD 2.0 SOTA를 달성했다.
method..
2개의 신경망을 학습사는데 generator G와 discriminator D를 학습한다. vector representation h(x) 와 embedding e, position t 일 때, generator는 softmax layer를 통해 다음과 같이 출력된다
discriminator는 다음과 같다
추가적으로 genrator와 discriminator 간에 sharing weights를 통해서 효율적으로 학습을 진행한다. 이 때 token과 positional embedding을 공유했다.S 이 때, discriminator 모델의 크기는 generator 보다 커야 수월하게 구별을 하면서 학습이 된다.
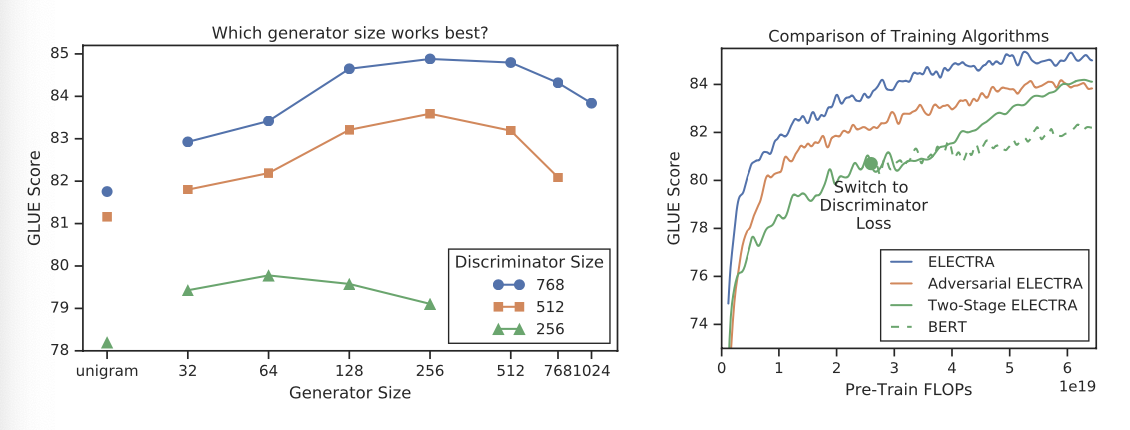
만약 사이즈가 같다면 거의 2배정도 더 학습을 진행해야 한다.
Training Algorithms
효과적으로 jointly train하는 two-stage 절차이다.
- generator MLM을 n step진행한다.
- generator의 weights로 discriminator를 Initialize한 후, generator의 weights를 멈춘 후에 discriminator를 n steps 학습한다.